
KI-Entwicklung · Lokale KI & On-Premise
Lokale KI für Unternehmen: On-Premise-LLM auf Eurem eigenen KI-Server
Lokale KI heißt: Das Sprachmodell rechnet auf einem Server, der Euch gehört, und nicht beim Anbieter eines Chatdienstes. Dokumente, Fragen und Antworten bleiben in Eurem Netz. Ihr mietet den Server nach unserer Vorgabe in einem deutschen Rechenzentrum oder betreibt ihn on premise im Haus. Wir wählen das Modell, richten alles ein, binden Euer Firmenwissen an und betreuen den Betrieb.
Zufriedene Kunden der Suchhelden GmbH



Das Wichtigste in Kürze
Was lokale KI für Dein Unternehmen bedeutet
Bei ChatGPT, Copilot und Co. geht jede Frage an die Server des Anbieters. Bei lokaler KI läuft ein offenes Sprachmodell auf Eurer eigenen Infrastruktur. Für Dein Team sieht das fast gleich aus: ein Chatfenster im Browser, Anmeldung mit dem gewohnten Firmenkonto. Der Unterschied liegt darunter. Kein Inhalt verlässt Eure Umgebung, und Ihr entscheidet, welches Modell in welcher Version läuft.
Unser Standard ist ein gemieteter GPU-Server in Deutschland, in der Regel bei Hetzner oder IONOS. Der Vertrag läuft zwischen Euch und dem Rechenzentrum, wir bekommen nur einen Verwaltungszugang. Wo Auflagen Hardware im eigenen Haus verlangen, setzen wir KI on premise gemeinsam mit einer Partnerfirma um, die vor Ort aufbaut und betreut.
Daten bleiben in Eurem Netz
Kein externer KI-Anbieter verarbeitet Eure Verträge, Zeichnungen oder Personalakten. Es entsteht kein neuer Datenweg ins Ausland.
Läuft ohne Verbindung nach außen
Eine Ausgangs-Firewall sperrt den Weg nach draußen. Das ist nachprüfbar, nicht nur zugesagt.
Euer Vertrag, Euer Server
Kein Vendor-Lock-in: Ihr könnt Modell, Hardware oder Dienstleister wechseln, ohne dass das System stillsteht.
Mit Eurem Firmenwissen
Handbücher, Arbeitsanweisungen und Vorgänge werden angebunden. Antworten nennen die Quelle im Dokument.
Entscheidungshilfe
Wann sich lokale KI lohnt – und wann nicht
Der häufigste Grund ist der Datenschutz. Laut Bitkom (2026) nennen 66 % der Unternehmen, die KI nutzen, Datenschutzanforderungen als Hemmnis. Gleichzeitig wissen oder vermuten 4 von 10 Unternehmen, dass Beschäftigte private KI-Konten für die Arbeit nutzen (Bitkom 2025). Ein Verbot ändert daran wenig. Ein freigegebenes lokales Werkzeug schon.
✓Lokale KI passt, wenn …
- Verträge, Kundenvereinbarungen oder Geheimhaltungspflichten die Cloud ausschließen, etwa in Zulieferung, Rüstung, Pharma oder bei Berufsgeheimnisträgern
- Netze bewusst abgeschottet sind: Fertigung, Labor, Verwaltung, kritische Infrastruktur
- ein festes Team täglich mit vertraulichen Dokumenten arbeitet
- Ihr unabhängig von Preis- und Modellwechseln eines Anbieters bleiben wollt
- Hintergrundaufgaben wie Belegprüfung oder Dokumentenauswertung viele Anfragen erzeugen
✕Eher nicht, wenn …
- nur zwei, drei Personen gelegentlich unkritische Texte schreiben
- Ihr für jede Aufgabe das jeweils stärkste Spitzenmodell braucht
- die Dokumente, die die KI kennen soll, noch ungeordnet in Postfächern liegen
- ein Business-Vertrag mit EU-Hosting Eure Anforderungen bereits erfüllt
Der ehrliche Vergleich
On premise, Rechenzentrum oder Cloud? Die drei Betriebsmodelle im Vergleich
„On premise vs. Cloud“ ist bei KI keine Entweder-oder-Frage, sondern eine Frage des Ortes. Dazwischen liegt der Weg, den wir am häufigsten empfehlen: ein eigener KI-Server, gemietet in einem deutschen Rechenzentrum.
| Cloud-KI per API oder Abo | Gemieteter KI-Server in Deutschland | Eigene Hardware im Haus (on premise) | |
|---|---|---|---|
| Bei KI-Helden | Für unkritische Aufgaben, Tests und Spitzenlast | Unser Standard | Nur in Absprache, mit Partnerfirma vor Ort |
| Wo gerechnet wird | Beim Anbieter, oft außerhalb der EU | Benanntes Rechenzentrum in Deutschland | In Eurem Serverraum |
| Vertrag | Nutzungsbedingungen des Anbieters | Euer Vertrag mit dem Rechenzentrum | Gerät gehört Euch |
| Modell | Vom Anbieter vorgegeben, ändert sich ohne Euch | Offenes Modell, Version legt Ihr fest | Offenes Modell, Version legt Ihr fest |
| Einstieg | Sofort | Kein Einkauf, Miete nach unserer Vorgabe | Beschaffung, Strom, Kühlung, Platz |
| Skalierung | Beliebig | Umzug auf größere Maschine beim selben Betreiber | Begrenzt auf das, was im Schrank steht |
| Ohne Internet nutzbar | Nein | Nur über Eure Verbindung erreichbar | Ja, auch komplett abgeschottet |
| Sinnvoll, wenn | Inhalte unkritisch sind und maximale Modellstärke zählt | Ihr Datenhoheit wollt, aber keine Hardware betreuen | Auflagen oder abgeschottete Netze das Haus vorgeben |
Wir empfehlen einen gestaffelten Weg. Ihr startet auf gemieteter Kapazität, weil sie schnell verfügbar ist und kein Kapital bindet. Dann messen wir die echte Auslastung und passen die Ausstattung an. Die Architektur bleibt dieselbe, egal ob der Server im Rechenzentrum oder später im eigenen Haus steht. Wer on premise als Ziel hat, kann also trotzdem ohne Beschaffung starten.
Mischformen sind normal: Vertrauliches läuft lokal, unkritische Aufgaben wie Marketingtexte dürfen über eine angebundene Cloud-KI laufen. Eine zentrale Vermittlungsschicht entscheidet nach Regeln, welche Anfrage wohin geht.
Begriffe
Lokal, on premise, offline: Was ist was?
Die Begriffe werden ständig vermischt. Für Eure Entscheidung zählt der Unterschied.
Lokale KI
Beschreibt, wo gerechnet wird: auf einem Gerät oder Server in Eurer Umgebung statt beim Anbieter. Sagt nichts über die Größe der Installation.
On Premise
„Auf dem eigenen Gelände“: Die Hardware steht in Euren Räumen. Im allgemeinen IT-Sprachgebrauch das Gegenteil von Cloud und Software as a Service.
Offline und Air-Gap
Beschreibt einen Zustand: keine Verbindung nach außen. Ein lokales Modell ist offline-fähig, aber erst eine gesperrte Ausgangsverbindung macht es nachweisbar offline.
Self-hosted und Private LLM
Ein Sprachmodell, das Ihr selbst betreibt oder betreiben lasst, ob im Haus oder auf einem gemieteten Server. Das Gegenstück ist der Zugriff per Schnittstelle auf ein fremdes Modell.
LLM-Hosting
Der Betrieb eines Sprachmodells auf dedizierter Infrastruktur im Rechenzentrum, mit Einrichtung, Überwachung und Updates.
Digitale Souveränität
Die Fähigkeit, über eigene Daten, Systeme und Anbieterwahl selbst zu entscheiden. Lokale KI ist dafür ein Baustein, eine souveräne Cloud in Europa ein anderer.
Technik
Woraus eine lokale KI besteht
Ein Modell allein tut nichts. Damit Dein Team damit arbeiten kann, braucht es vier Bausteine. Werkzeuge wie Ollama, vLLM oder Open WebUI sind dabei keine Alternativen zueinander, sondern Teile eines Stapels. Welches wofür passt, beschreiben wir in unserem Werkzeugvergleich.
Wir arbeiten modellunabhängig. Die Modelle testen wir an Euren echten Aufgaben und auf Deutsch, nicht an Ranglisten. Und wir prüfen die Lizenz mit, denn nicht jedes offen verfügbare Modell darf uneingeschränkt kommerziell genutzt werden.
Offenes Sprachmodell
Zum Beispiel aus den Familien Llama, Mistral, Qwen, Gemma oder DeepSeek. Welches passt, steht im Vergleich offener Modelle.
Laufzeitumgebung
Lädt das Modell und rechnet die Antworten. Schlanke Werkzeuge wie Ollama für kleine Installationen, vLLM für viele gleichzeitige Anfragen.
Oberfläche und Anmeldung
Ein Chatfenster wie Open WebUI, angebunden an Euer Benutzerverzeichnis, mit Rollen, Vorlagen und Protokoll.
Wissensanbindung
Sucht bei jeder Frage die passenden Stellen in Euren Dokumenten. Mehr zu RAG und KI-Wissensdatenbank.
Hardware
Welche Hardware braucht lokale KI?
Der wichtigste Wert ist der Grafikspeicher (VRAM) der GPU. Das Modell muss vollständig hineinpassen, dazu kommt Platz für laufende Anfragen und lange Texte. Maßgeblich ist dabei die Größe der Modelldatei in Gigabyte, nicht die Zahl der Parameter. Bei Mixture-of-Experts-Modellen müssen auch die gerade nicht aktiven Teile in den Speicher (onprem.ai).
Kleine Modelle
Bis etwa 15 Milliarden Parameter. Laufen auf einer GPU mit 24 bis 48 GB (axio concept). Gut für Zusammenfassen, Einordnen und Extrahieren, für einzelne Arbeitsplätze und Notebooks.
Mittlere Modelle
Rund 30 Milliarden Parameter, laut onprem.ai auf einer GPU mit 96 GB. Deutlich rundere Antworten auf Deutsch. Für viele Teams im Mittelstand der sinnvolle Einstieg.
Große Modelle
Ab mehreren hundert Gigabyte Modellgröße, verteilt auf mehrere GPUs. Nah an den Cloud-Spitzenmodellen, aber mit entsprechendem Aufwand bei Miete oder Anschaffung.
✓Daraus ergibt sich das Lastprofil
- Wie viele Menschen fragen gleichzeitig, nicht wie viele Mitarbeiter es insgesamt gibt
- Welche Antwortzeit ist im Alltag akzeptabel
- Wie lang sind die Dokumente, die in eine Antwort einfließen
- Laufen Hintergrundaufgaben, etwa das Auswerten eingehender Post
✓Warum wir zum Rechenzentrum raten
- Ein GPU-Server zieht viel Strom, erzeugt Abwärme und ist laut
- Kühlung, Stromversorgung und Ersatzteile übernimmt der Betreiber
- Keine Lieferzeit, keine Kapitalbindung, kein Wiederverkauf
- Wächst der Bedarf, zieht Ihr auf eine größere Maschine um
Welche Ausstattung zu welchem Lastprofil passt und was ein KI-Server im Einzelnen braucht, steht auf der eigenen Seite. Für Hardware im eigenen Haus haben wir einen Ratgeber zum On-Premise-LLM.
Vertiefen
Lokale KI im Detail: unsere Ratgeber
Zu jeder Frage rund um eigene Sprachmodelle gibt es eine eigene Seite.
KI-Server und GPU-Server
Mieten, im Haus betreiben oder Cloud-Kapazität buchen: Betriebsmodelle, Ausstattung und wem die Infrastruktur gehört.
02On-Premise-LLM
KI on premise auf eigener Hardware: wann es nötig ist und was der Betrieb im eigenen Haus wirklich verlangt.
03LLM-Hosting
Euer eigenes Sprachmodell auf deutscher Infrastruktur, betreut von der Modellauswahl bis zum Betrieb.
04Ollama, vLLM und Open WebUI
Welches Werkzeug löst welches Problem? Der Vergleich mit Blick auf den Betrieb im Unternehmen.
05Open-Source-LLMs im Vergleich
Llama, Mistral, Qwen, DeepSeek, Gemma: Auswahlkriterien, Modellgrößen und Lizenzen.
06ChatGPT offline nutzen
Was ohne Internet wirklich geht und was nicht, auf dem eigenen Rechner und im Unternehmen.
07DSGVO-konforme KI
Serverstandort, Auftragsverarbeitung, Mitarbeiterdaten: die Datenschutzfragen vor jedem KI-Projekt.
Lohnt sich lokale KI für Euren Fall?
Im kostenlosen Erstgespräch klären wir Aufgaben, Datenlage und Lastprofil und sagen Dir ehrlich, welcher Weg passt.
Einsatzfelder
Wofür Unternehmen lokale KI einsetzen
Fast immer beginnt es mit einem eng umrissenen Anwendungsfall. Von dort wächst die Lösung weiter.
Produktion und technischer Service
Störmeldungen einordnen, in Betriebsanleitungen nachschlagen, frühere Fälle mit ähnlichen Symptomen finden. Funktioniert auch im getrennten Hallennetz.
02Verträge und vertrauliche Unterlagen
Verträge gegen Vorgaben prüfen, Angebote aus vertraulichen Preislisten entwerfen, Lastenhefte durchsuchen, ohne dass etwas das Haus verlässt.
03Personal und Geschäftsführung
Bewerbungen sichten, Protokolle zusammenfassen, Entwürfe für interne Schreiben. Gerade hier sind die Daten zu sensibel für fremde Server.
04Dokumente auslesen
Rechnungen, Lieferscheine und Prüfberichte erfassen und an ERP oder DMS übergeben, auch große Aktenbestände.
05Wissen sichern
Wenn erfahrene Kolleginnen und Kollegen in Rente gehen, bleibt ihr Wissen in Arbeitsanweisungen, Fallberichten und Handbüchern durchsuchbar.
06Labore und abgeschottete Netze
Messdaten, Rezepturen und Prüfergebnisse bleiben in der Zone, in der sie ohnehin liegen. Ein zusätzlicher Datenweg entsteht nicht.
Kosten
Was kostet lokale KI?
Bei uns besteht eine lokale KI aus zwei Teilen. Die Servermiete zahlt Ihr direkt an das Rechenzentrum. Unsere Arbeit für Aufbau, Betreuung und Training rechnen wir als Retainer auf Stundenbasis ab: ein Stundenkontingent, monatlich kündbar – die unkomplizierte KI-Abteilung Eures Unternehmens, ohne die Nachteile einer eigenen Abteilung. Größere Vorhaben setzen wir auch als einmaliges Projekt um, zu 85 € pro Stunde. Bei uns zahlst Du nur die Stunden, die wirklich anfallen.
Zur Orientierung, was der Markt für eigene Hardware nennt: Ein Einstiegs-Setup liegt laut axio concept bei 8.000 bis 16.000 € Hardware. Fertige KI-Server für 20 bis 100 Mitarbeitende kosten laut Mindspace 6.490 bis 14.990 € netto. Ein Server mit vier Profi-GPUs für große Modelle liegt laut deep5 bei rund 67.000 bis 80.000 € netto (Stand Herbst 2026). Bei Miete fallen diese Beträge nicht auf einmal an.
Modellgröße
Bestimmt den Grafikspeicher und damit die Servermiete am stärksten.
Gleichzeitige Nutzer
Mehr parallele Anfragen brauchen mehr Rechenleistung, nicht nur ein größeres Modell.
Anbindungen
Jede Quelle wie DMS, SharePoint oder ERP ist Aufwand, besonders mit Zugriffsrechten.
Abschottung
Ein vollständig abgeschotteter Betrieb macht Updates und Wartung aufwendiger.
Vorgehen
So bauen wir Eure lokale KI auf: in sechs Schritten
Ihr mietet den Server, wir machen daraus Eure KI und bleiben dabei, bis sie leistet, was sie soll.
Ziele verstehen
Welche Aufgaben übernimmt die KI, mit welchen Daten, für wie viele Menschen gleichzeitig? Daraus werden messbare Ziele und das Lastprofil.
Modelle und Stack wählen
Wir testen Modelle an Euren echten Aufgaben und leiten daraus die Server-Vorgabe ab. Ihr bekommt ein Konzept mit Ausstattung, Betriebsmodell und Angebot, bevor etwas gemietet wird.
Ihr mietet den Server
Bei einem Rechenzentrumsbetreiber in Deutschland, auf Euren Namen. Wir bekommen einen Verwaltungszugang. Hardware im Haus nur in Absprache mit unserer Partnerfirma.
Einrichten und betreuen
Treiber, Laufzeit, Ausgangs-Firewall, Anmeldung über Euer Benutzerverzeichnis, Protokollierung, Backups. Danach Updates in Wartungsfenstern und Überwachung über die gesamte Laufzeit. Reaktionszeiten und Bereitschaft legen wir nach Vereinbarung fest.
Einführen
Wissensquellen anbinden, Vorlagen für wiederkehrende Aufgaben anlegen. Zuerst arbeitet eine Testgruppe an echten Fällen, dann folgt der Start mit Schulung Eures Teams.
Trainieren, bis die Ziele erreicht sind
Wir messen die Antworten gegen die Ziele aus Schritt 1 und verbessern in festen Runden. Für ein Nachtraining nutzen wir nie echte Daten, sondern gemeinsam erstellte Beispiele.
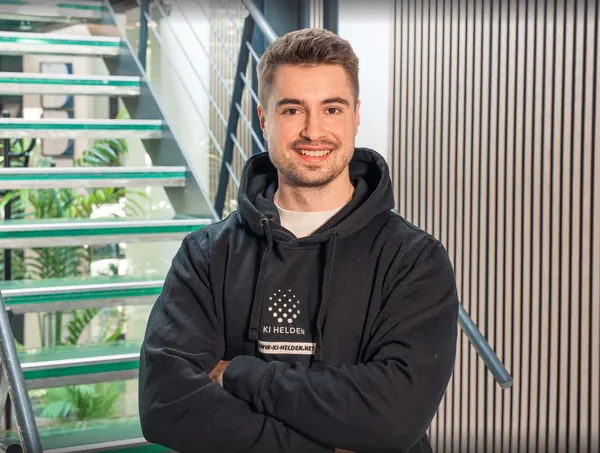
Malte Hundertmark – KI-Experte bei KI-Helden
Kernaussage
„Bei Servern für KI wird meistens zu groß oder zu klein gedacht. Zu groß, weil jemand das größte Modell laden will, das es gibt. Zu klein, weil der erste Test auf einem Arbeitsplatzrechner gut lief. Der richtige Server ergibt sich aus dem Lastprofil – und das lässt sich in einem Gespräch klären.“
Sicherheit und Datenschutz
Was lokale KI absichert – und was nicht
Ohne externen KI-Anbieter entfällt der heikelste Datenweg. Automatisch sicher oder DSGVO-konform ist ein lokales System damit aber noch nicht. Die rechtliche Bewertung Eures Falls bleibt bei Eurem Datenschutzbeauftragten. Wir liefern die technischen Grundlagen und die Dokumentation dafür, auch für das Gespräch mit dem Betriebsrat.
✓Das richten wir standardmäßig ein
- Ausgangs-Firewall: Nur ausdrücklich Freigegebenes darf nach außen, blockierte Versuche werden protokolliert
- Anmeldung über Euer Benutzerverzeichnis, Rechte je Rolle und Abteilung
- Zugriffsrechte der Quellen werden übernommen: Wer ein Dokument nicht sehen darf, bekommt es auch nicht als Antwort
- Updates über einen festgelegten Weg: Wartungsfenster, eng begrenzte Freigabe oder Datenträger, mit Rückfallebene
✕Typische Lücken trotz eigenem Server
- Dauerhaft offene Wartungszugänge statt zeitlich begrenzter
- Software, die Nutzungsdaten unbemerkt an Hersteller meldet
- Echte Daten als Testdaten auf Entwicklerrechnern
- Präparierte Dokumente, die das Modell mit versteckten Anweisungen steuern (Prompt Injection), mehr dazu bei Anwendungssicherheit
Ehrlich gesagt
Wo lokale KI an Grenzen stößt
Ein lokal laufendes Modell ist nicht in allem so stark wie das jeweils größte Cloud-Modell. Bei langen Ketten aus logischen Schlüssen, anspruchsvoller Programmierarbeit, sehr großen Kontexten sowie Bild und Video liegen die Spitzenmodelle je nach Aufgabe vorn. Wer das wegredet, verkauft eine Enttäuschung.
Für den größten Teil der Büroarbeit spielt das kaum eine Rolle. Zusammenfassen, Suchen, Einordnen und Fragen an Dokumente schaffen gute offene Modelle zuverlässig. Der Nutzen entsteht meist durch die Anbindung an Eure Unterlagen.
Auf einen Blick
- Monatlich kündbar
- Modellunabhängig
- EU-Hosting
- 85 € pro Stunde
Weltwissen
Das Modell kennt nur seinen Trainingsstand.
Pflege
Modelle werden abgelöst, Sicherheitsupdates fallen an. Ohne Zuständigkeit veraltet jedes System.
Ordnung der Daten
Eine KI findet nur, was strukturiert und mit Rechten versehen vorliegt.
Der falsche Start
„Chat mit allen Dokumenten“ als erstes Projekt enttäuscht oft. Besser ein klarer Anwendungsfall.
Eignungs-Check
Passt lokale KI zu Euch? Fünf Fragen
Beantwortest Du drei oder mehr mit Ja, lohnt sich ein Gespräch über einen Pilot mit einer Abteilung.
- Dürfen bestimmte Inhalte nach Vertrag, Gesetz oder interner Regel nicht zu einem Cloud-Anbieter?
- Nutzen Mitarbeitende heute schon private KI-Zugänge, weil es kein freigegebenes Werkzeug gibt?
- Arbeiten mindestens zehn Personen regelmäßig mit Dokumenten, die eine KI durchsuchen könnte?
- Gibt es Netze oder Standorte ohne verlässliche Verbindung nach außen?
- Wollt Ihr selbst bestimmen, welches Modell in welcher Version läuft?
Warum KI-Helden
Aus der Praxis, für die Praxis.
Keine lange Vertragsbindung. Volle Flexibilität, volle Kostenkontrolle.
Kein Recruiting, keine Fixkosten, keine Einarbeitung: Ihr bucht Stunden nach Bedarf. Einzelprojekte zu 85 € pro Stunde.
Keine Bindung an ein LLM. Wir wechseln das Modell, wenn ein besseres für Eure Aufgaben da ist.
Persönlicher Ansprechpartner, Jour-Fixe-Calls und dediziertes Umsetzungsteam der Suchhelden GmbH aus Osnabrück.
Dein Modell. Dein Server. Keine Verbindung nach außen.
Lass uns klären, ob sich lokale KI für Euch lohnt, welches Modell zu Euren Aufgaben passt und wo Ihr am besten startet. Kostenlos und unverbindlich, eine erste Demo ist oft ebenfalls kostenlos.
Fragen & Antworten
Häufige Fragen zu lokaler KI
KI-Helden in Osnabrück
Heinrichstraße 14c49080 Osnabrück
- Montag bis Donnerstag
- 08:30–17:00 Uhr
- Freitag
- 08:30–15:00 Uhr
- Samstag und Sonntag
- Geschlossen
Was ist lokale KI?
Lokale KI bedeutet, dass ein Sprachmodell auf einem Gerät oder Server in Deiner Umgebung rechnet und nicht beim Anbieter eines Chatdienstes. Frage, Dokumente und Antwort bleiben im eigenen Netz. Für den laufenden Betrieb ist keine Verbindung nach außen nötig.
Was bedeutet On-Premise bei KI?
On-Premise heißt wörtlich „auf dem eigenen Gelände“: Die Hardware steht in Euren Räumen und wird von Euch oder einem Dienstleister betrieben. Bei KI meint man damit ein Sprachmodell, das auf eigenen Servern läuft statt in der Cloud eines Anbieters.
Ist ein gemieteter Server noch lokale KI?
Ja, wenn er abgeschottet ist. Entscheidend ist nicht, wem das Blech gehört, sondern wer darauf zugreifen kann. Der Mietvertrag läuft auf Euren Namen, das Rechenzentrum steht in Deutschland, der Server ist nur über Eure Verbindung erreichbar und baut selbst keine Verbindung nach außen auf.
Welche Hardware braucht lokale KI?
Das hängt an Modellgröße und an der Zahl gleichzeitiger Nutzer. Entscheidend ist der Grafikspeicher (VRAM) der GPU: Das Modell muss vollständig hineinpassen, dazu kommt Platz für die laufenden Anfragen. Kleine Modelle laufen auf einem Arbeitsplatzrechner mit guter Grafikkarte, für ein Team braucht es einen GPU-Server.
Was kostet eine lokale KI-Lösung?
Aus zwei Teilen. Die Servermiete zahlt Ihr direkt an das Rechenzentrum, ihre Höhe hängt vor allem an Modellgröße und Nutzerzahl. Unsere Arbeit für Aufbau, Betreuung und Training rechnen wir als Retainer auf Stundenbasis ab: ein Stundenkontingent, monatlich kündbar – die unkomplizierte KI-Abteilung Eures Unternehmens, ohne die Nachteile einer eigenen Abteilung. Größere Vorhaben setzen wir auch als einmaliges Projekt um, zu 85 € pro Stunde. Bei uns zahlst Du nur die Stunden, die wirklich anfallen. Eine erste Demo ist oft kostenlos.
Sind lokale Modelle schlechter als ChatGPT?
Bei langen Schlussketten, anspruchsvollem Programmieren, sehr großen Kontexten und Bildverarbeitung sind die größten Cloud-Modelle weiter vorn. Für Zusammenfassen, Suchen, Einordnen, Formulieren und Fragen an eigene Dokumente sind gute offene Modelle im Alltag stark genug. Entscheidend ist meist, ob das System Eure Unterlagen kennt.
Kann man ChatGPT lokal installieren?
Nein. Die Modelle der großen Chatdienste werden nicht zum Herunterladen angeboten. Was geht: ein frei verfügbares Modell lokal betreiben und über eine ähnliche Chat-Oberfläche nutzen. Mehr dazu in unserem Ratgeber, ob ChatGPT offline funktioniert.
Welche Modelle laufen lokal?
Alle offenen Sprachmodelle, deren Modelldatei zum Herunterladen freigegeben ist, zum Beispiel aus den Familien Llama, Mistral, Qwen, Gemma oder DeepSeek. Es gibt sie in vielen Größen. Wir prüfen immer die Lizenz mit, denn nicht jedes offen verfügbare Modell darf uneingeschränkt kommerziell eingesetzt werden.
Ist lokale KI automatisch DSGVO-konform?
Sie ist eine sehr gute Ausgangslage, weil kein externer KI-Anbieter Inhalte verarbeitet und die Daten in Deutschland bleiben. Zugriffsrechte, Protokollierung, Löschkonzepte und der Umgang mit personenbezogenen Daten bleiben trotzdem Aufgaben. Diese planen wir mit. Eine Rechtsberatung leisten wir nicht. Die Bewertung Eures Falls gehört zu Deinem Datenschutzbeauftragten.
Wie kommen unsere Dokumente in die lokale KI?
Über eine Wissensanbindung (RAG). Eure Unterlagen werden aufbereitet und durchsuchbar gemacht. Bei jeder Frage sucht das System die passenden Stellen und legt sie dem Modell vor, die Antwort nennt die Quelle. Der ganze Vorgang läuft in Eurem Netz, bestehende Zugriffsrechte lassen sich übernehmen.
Können wir klein anfangen?
Ja, und wir empfehlen es. Ein Standort, eine Abteilung, ein klar umrissener Anwendungsfall. Das zeigt schnell, ob der Nutzen trägt und welche Fragen im Alltag wirklich gestellt werden. Weil der Server gemietet ist, lässt er sich später auf eine größere Maschine umziehen, ohne dass sich an der Architektur etwas ändert.